Web-Monitoring bezeichnet die systematische Sammlung, Sortierung und Analyse von online veröffentlichten Informationen zur Unterstützung von Geschäftsentscheidungen. Im Jahr 2024 macht das Volumen der täglich indexierten Inhalte eine manuelle Sortierung unpraktikabel. Die Optimierung des Web-Monitorings erfordert eine Neubewertung der Methode, bevor ein Werkzeug ausgewählt wird.
Filterung durch schwache Signale: die Fähigkeit, die das Schlüsselwort ersetzt
Die meisten Leitfäden zum Monitoring beginnen mit der Auswahl von Werkzeugen. Der eigentliche Ausgangspunkt liegt jedoch weiter oben: zu definieren, welche schwachen Signale erfasst werden sollten. Ein schwaches Signal ist eine noch marginale Information (ein eingereichtes Patent, eine Änderung der Formulierung bei einem Wettbewerber, eine wiederkehrende Frage in einem Nischenforum), die einen Trend ankündigt, bevor er in den allgemeinen Medien sichtbar wird.
Spezialisierte Akteure im Bereich Monitoring beschreiben eine Umgestaltung des Berufs des Monitorings: weniger Zeit wird mit der Sammlung und Sortierung verbracht, mehr mit der Analyse und Szenarierung von Risiken oder Chancen dank Plattformen, die durch künstliche Intelligenz angereichert sind. Die zentrale Fähigkeit wird die Fähigkeit, Alarmströme in umsetzbare Hypothesen zu verwandeln, anstatt Abfragen zu konfigurieren.
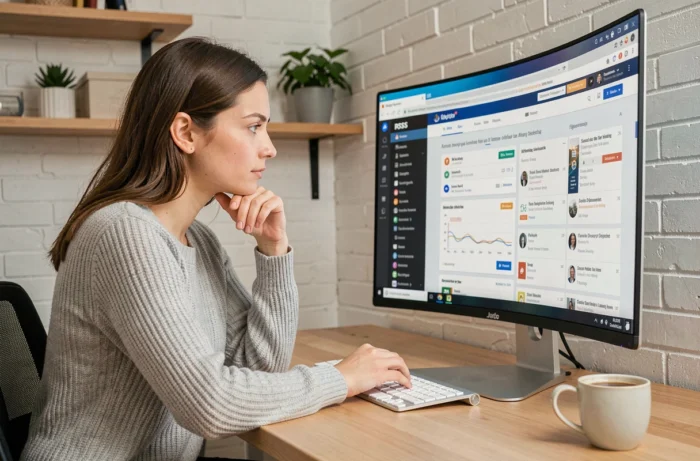
Konkreter bedeutet dies, dass ein Dashboard, das mit Google-Alarmen zu generischen Schlüsselwörtern (“SEO”, “Digitales Marketing”) gefüllt ist, Lärm produziert. Ein System, das die Patente eines bestimmten Wettbewerbers, die Änderungen seiner rechtlichen Seiten oder die veröffentlichten Stellenangebote auf LinkedIn überwacht, produziert ein Signal. Der Unterschied liegt im Überwachungsbereich und der Granularität der Abfragen, nicht in der Anzahl der gestapelten Werkzeuge.
Ressourcen wie unser Web-Monitoring ermöglichen es, diese Sammlung zu strukturieren, indem sie bereits gefilterte thematische Ströme bündeln, was die tägliche Sortierzeit reduziert.
Prädiktives Monitoring und KI: Unterscheidung zwischen echter Analyse und automatisierter Sortierung
Künstliche Intelligenz, die auf das Monitoring angewendet wird, umfasst zwei unterschiedliche Realitäten, die getrennt werden müssen, um Enttäuschungen zu vermeiden.
Automatisierte Sortierung durch Klassifizierung
Die erste Schicht, die am weitesten verbreitet ist, besteht darin, eingehende Inhalte automatisch nach Thema, Tonalität oder Relevanz zu klassifizieren. Aggregatoren wie Feedly integrieren eine Engine (Leo AI), die den Artikeln basierend auf den vom Benutzer definierten Interessen eine Prioritätsbewertung zuweist. Diese Sortierung beschleunigt das Lesen, produziert jedoch keine Analyse. Sie bleibt eine Filterfunktion.
Prädiktives Monitoring durch Korrelation
Die zweite Schicht, die neuer ist, verknüpft heterogene Quellen (Patente, Stellenangebote, wissenschaftliche Veröffentlichungen, Finanzdaten), um unsichtbare Korrelationen zu erkennen. Informationsmonitoring-Lösungen erklären, dass die KI nicht mehr nur filtert, sondern vorausschauende Hypothesen anbietet, indem sie disparate Daten miteinander verbindet.
Die Unterscheidung ist wichtig, weil ein Sortierwerkzeug keinen Analysten ersetzt. Die Automatisierung der Sammlung schafft Zeit. Die Automatisierung der Interpretation erfordert die Überprüfung jeder vorgeschlagenen Korrelation. Verwechslung der beiden führt zu Entscheidungen, die auf statistischen Artefakten basieren.
- Die automatisierte Sortierung reduziert das tägliche Lesevolumen erheblich, erkennt jedoch keine schwachen Signale außerhalb des konfigurierten Umfangs.
- Das prädiktive Monitoring bietet Verknüpfungen zwischen Quellen, vorausgesetzt, es stehen ausreichend vielfältige Ströme zur Verfügung (nicht nur Blogs aus demselben Sektor).
- Keine der beiden Schichten beseitigt die Notwendigkeit eines menschlichen Blicks, um die Relevanz eines Signals zu validieren, bevor es in eine Aktion umgesetzt wird.
Strukturierung eines Web-Monitoring-Zyklus: Rhythmus und Rückmeldung
Ein effektives Monitoring-System basiert weniger auf der Menge der Quellen als auf der Regelmäßigkeit des Zyklus und der Qualität der Rückmeldung. Drei Zeitrahmen ergänzen sich.
Die tägliche Überprüfung dauert zwischen zehn und fünfzehn Minuten. Sie besteht darin, die gefilterten Alarme zu scannen und die Elemente zu markieren, die eine weitere Bearbeitung verdienen. Zu diesem Zeitpunkt wird keine Analyse produziert: Das Ziel ist es, zu erkennen, nicht zu verstehen.
Die wöchentliche Zusammenfassung fasst die während der Woche markierten Signale zusammen. Zu diesem Zeitpunkt verfasst der Monitor eine kurze Notiz (fünf bis zehn Zeilen), die die Signale miteinander verbindet und eine Hypothese oder Empfehlung formuliert. Diese Notiz wird mit den betroffenen Entscheidungsträgern geteilt.
Der monatliche Bericht dient dazu, das System anzupassen: Quellen hinzufügen oder entfernen, Abfragen ändern, bewerten, ob die Hypothesen des vorhergehenden Monats bestätigt wurden. Ein Monitoring-System, das sich nicht jeden Monat neu kalibriert, driftet innerhalb weniger Wochen in den Lärm ab.
RGPD-Konformität und rechtliche Grenzen des Online-Monitorings
Web-Monitoring beinhaltet manchmal die Sammlung von Daten über identifizierbare Personen: soziale Profile von konkurrierenden Führungskräften, namentliche Kundenbewertungen, Veröffentlichungen von Mitarbeitern. Diese Sammlung fällt in den Bereich der RGPD, sobald sie systematisch und organisiert erfolgt.
Der Hauptpunkt der Aufmerksamkeit betrifft die Aufbewahrung und den Austausch von personenbezogenen Daten, die während des Monitorings gesammelt wurden. Das Archivieren von Screenshots von LinkedIn-Profilen in einem gemeinsamen Ordner stellt eine Verarbeitung personenbezogener Daten im Sinne der Verordnung dar. Die Aufbewahrungsdauer muss im Verhältnis zum angegebenen Zweck stehen.
Die Social Listening-Tools, die öffentliche Erwähnungen aggregieren, bleiben rechtmäßig, solange die Daten nicht angereichert oder mit internen Dateien ohne rechtliche Grundlage verknüpft werden. Die Grenze zwischen legitimen Wettbewerbsmonitoring und übermäßiger Überwachung hängt von der Verhältnismäßigkeit des Systems ab.
- Die Zweckbestimmung jedes Monitoring-Stroms, der personenbezogene Daten enthält, dokumentieren.
- Die Aufbewahrung namentlicher Daten auf die strikt notwendige Dauer für die Analyse beschränken.
- Externe Monitoring-Daten nicht ohne separate rechtliche Grundlage mit HR- oder Kundendateien verknüpfen.
- Überprüfen, dass die verwendeten Werkzeuge die Daten unter Bedingungen speichern, die mit der RGPD konform sind.
Die Strukturierung des Monitorings im Jahr 2024 bedeutet, zwischen Analysevertiefung und Quellenvolumen abzuwägen. Ein kurzer Zyklus, präzise Abfragen und regelmäßige Rückmeldungen erzeugen mehr Wert als eine Ansammlung von Abonnements für Werkzeuge. Der letzte Reflex, den man beibehalten sollte: eine Quelle zu entfernen, die seit einem Monat nichts Umsetzbares produziert hat.